People & Computers
כתבה מובילה
שומרים על הגבול: ה-AI שתעצור אתכם מחשיפת יתר ברשת
מדי יום, רבים מאתנו מעלים מידע אישי עלינו לרשתות החברתיות ולאפליקציות שונות – בין אם תמונה שלנו עם חברים במסעדה, סרטון מהופעה שהיינו בה או, חשוב יותר, נתונים פרסונליים. זה יכול להיות נתונים פיננסיים, אבל גם אימון הכושר שלנו, מה רכשנו אונליין ועוד. חלקנו לא מודעים לסיכוני הפרטיות שכרוכים בכך, ובדרך כלל, גם מי שיש לו איזה מידע עליהם לא נותן את הדעת לזה עד הסוף, ומשאיר את המידע שלו פתוח וחשוף לכל. חוקרים מאוניברסיטת אריאל – ד"ר שני אלקובי, ד"ר רון ס. הירשפרונג ובנג'י עזריה – פיתחו מערכת מבוססת בינה מלאכותית, שנועדה להעריך בפני המשתמש את רמת הרגישות של הטקסט, ולהתריע כאשר התוכן פרטי או רגיש מדי, רגע לפני שהוא מעלה אותו לרשת. הפיתוח מציע כלים משמעותיים להתמודדות עם הסכנות ברשת, ויכול להיות קריטי במיוחד עבור הורים למתבגרים. בני נוער נוטים לשתף תוכן אישי באופן ספונטני, ומערכת שכזו יכולה לתפקד כמעין תמרור אזהרה חכם שיעצור אותם רגע לפני השיתוף, ויעזור להם לקבל החלטות מודעות ובטוחות יותר. גם כאן: רווח מול הפסד ד"ר אלקובי היא חברת סגל במחלקה להנדסת תעשייה וניהול באוניברסיטת אריאל. היא עשתה דוקטורט במדעי המחשב באוניברסיטת בר אילן, ולאחר שנתיים של פוסט דוקטורט באוסטין, טקסס, חזרה לאריאל. ביום יום היא חוקרת מערכות מרובות סוכנים – אינטראקציה בין סוכנים ממוחשבים, בינם לבין אנשים, אסטרטגיות שונות, את תורת המשחקים ואיך אפשר להשתמש במידע כמשאב. הפרטיות היא חלק אינהרנטי מתחומי העיסוק שלה. לדבריה, "אנחנו נותנים את המידע שלנו מבלי לחשוב, ויש מי שאוסף ושומר אותו. אנחנו צריכים לחשוב האם, כמשתמשים, נתינת הדאטה מניבה לנו יותר רווח או הפסד". ד"ר אלקובי נותנת שתי דוגמאות: "למשל, משתמש שמפרסם פוסט שהוא תומך במפלגה מסוימת בבחירות – מפלגה אחרת יכולה 'לראות' את המידע הזה, לפנות אליו ולהציע לו להצביע עבורה. או, נניח, אני מפרסמת שאני בחו"ל – ומישהו רואה את המידע הזה ופורץ לבית שלי". הרשתות החברתיות והאפליקציות נהנות מהמצב הזה, ועונות לדרישות הרגולציה בכך שהן יוצאות ידי חובה. "הארגונים האלה מהירים יותר מהרגולציה. הם גם חכמים יותר ממנה – הם מפרסמים 'מגילה' שאף אחד לא קורא. זה המון טקסט בשפה מסורבלת ומשפטית. אתה לא מבין את השפה הזאת ורוצה כל כך לקבל את המוצר – אז אתה לא קורא ולוחץ 'OK' באופן אוטומטי. זה נקרא עצלנות קוגניטיבית. בכך החברות מכסות את עצמן, אבל אנחנו, המשתמשים, בכל זאת נפגעים", אמרה ד"ר אלקובי. הצד הטכנולוגי של המחקר בתוך הסוגייה של הגנת הפרטיות יש תת סוגייה: לא כל אחד תופס את הפרטיות שלו, והגנתה, באותה הצורה. אדם אחד ישתף ברשתות החברתיות, לדוגמה, שהוא לא מרגיש טוב, ואדם אחר לא, כי לתפיסתו, הוא יפגע בכך בפרטיות שלו. "ההנחה שהפרטיות והפגיעה בה הן אותו הדבר אצל כולם היא שגויה. הפגיעה בפרטיות צריכה להיבחן בצורה אישית", ציינה החוקרת. זוהי אחת מנקודות ההנחה שאיתן היא ועמיתיה יצאו למחקר שלהם. החוקרים ביצעו את המחקר באמצעות פלטפורמת מיקור ההמונים של אמזון. הם ביקשו מהמשתתפים לענות על שאלון שבנה את הפרופיל האישי של כל אחד מהם: הנתונים הדמוגרפיים שלהם – גיל, מגדר, השכלה, מוצא ועוד – ועסק באופן שבו הם תופסים פגיעה בפרטיות. תהליך המחקר בחלק השני של המחקר, מבצעיו השתמשו ב-API של X, שנותן גישה לציוצים רבים, אולם ללא שמות. ד"ר אלקובי מתארת את השלבים של החלק הזה: "בשלב הראשון ביצענו איסוף וניקוי של הנתונים. דגמנו 1.5 מיליון טוויטים רק כדי להבין את ההתפלגות של המילים בהם. מתוכם בחרנו 600 טוויטים, כדי שהמדגם יהיה כמה שיותר קרוב לאוכלוסייה שאנחנו רוצים לסקור. הורדנו אזכורים, כפילויות ואימוג'ים, על מנת שיהיה רק טקסט קריא, ויצרנו שישה 'ציוצי בקרה' – שלושה שבטוח פוגעים בפרטיות ושלושה שבטוח לא". "לאחר מכן", ציינה, "כל משתמש קיבל 20 טוויטים רנדומליים פלוס השישה של הבקרה. לכל ציוץ הוא נתן ציון בין 1 ל-5 עד כמה לדעתו הוא פוגע בפרטיות, כאשר 1 מסמל שהוא לא פוגע כלל ו-5 – שהוא פוגע מאוד. אספנו תשובות מ-1,489 משתתפים וסיננו את אלה שעלה חשד לגבי האמינות של תשובותיהם. נשארנו עם 471 משתתפים. כל המשתתפים היו בני 18+, אבל רק מיעוטם בני 60 ומעלה". כדי להפוך כל ציוץ למשהו שכלי ה-AI שאיתו החוקרים עבדו יוכל להבין, הם השתמשו ב-NLP (עיבוד שפה טבעית), שהוא היכולת של המחשב להבין טקסט אנושי, ולימוד מכונה, ובתוך זה בלמידה מפוקחת – קבלת החלטות על פי דוגמאות ספציפיות. "לקחנו את הנתונים, התייחסנו לכל נקודת דאטה כטקסט, שילבנו את זה עם הפרופיל האישי של המשתמש ולפי זה הגדרנו את הפגיעה בפרטיות", אמרה ד"ר אלקובי. "השתמשנו בטכנולוגיה של גוגל, שממירה את הטקסט לווקטורים, שמייצגים את המילים אבל גם את הכוונה של המשפט. הבעיה היא שהכלי הזה ייצר עבורנו כל וקטור עם 768 ממדים (פרופילים מתומצתים, שמייצגים את המשתמש והטקסט – י"ה). לנתח משהו אונליין עם מספר ממדים כה גבוה זה לא ריאלי. השתמשנו בכלי להפחתת ממדים, ובסופו של דבר הגענו ל-92 ממדים. אז שילבנו את למידת המכונה, כאשר היא למדה בפועל 75% מהנתונים, וביתר השתמשנו לבקרה". התוצאות, לדבריה, היו משביעות רצון: הפער הממוצע בין התיוגים של המשיבים לממצאים של המכונה היה 0.18 בלבד, כאשר ב-96.6% מהמקרים, הוא היה פחות מ-0.4. ד"ר רון ס. הירשפרונג (מימין) ובנג'י עזריה מאוניברסיטת אריאל. צילום: פרטי (עיבוד ממוחשב: ג'מיני) השוויתם את המחקר שלכם מול מחקרים אחרים שנעשו בתחום? כל מחקר צריך להציג חידוש לעומת המחקרים האחרים. מה החידוש במחקר שהצגתם? מה עם אבטחת המערכת? המשתמשים מכניסים לשם נתונים אישיים, וגם כאן עלולה להיות פגיעה בפרטיות. אם וכאשר המערכת שלכם תגיע לפרודקשן ותצא לשוק – במה היא יכולה להועיל לי, כמשתמש? הפוסט שומרים על הגבול: ה-AI שתעצור אתכם מחשיפת יתר ברשת הופיע ראשון באנשים ומחשבים - פורטל חדשות היי-טק, מיחשוב, טלקום, טכנולוגיות
מדי יום, רבים מאתנו מעלים מידע אישי עלינו לרשתות החברתיות ולאפליקציות שונות – בין אם תמונה שלנו עם חברים במסעדה, סרטון מהופעה שהיינו בה או, חשוב יותר, נתונים פרסונליים. זה יכול להיות נתונים פיננסיים, אבל גם אימון הכושר שלנו, מה רכשנו אונליין ועוד.
חלקנו לא מודעים לסיכוני הפרטיות שכרוכים בכך, ובדרך כלל, גם מי שיש לו איזה מידע עליהם לא נותן את הדעת לזה עד הסוף, ומשאיר את המידע שלו פתוח וחשוף לכל. חוקרים מ אוניברסיטת אריאל – ד"ר שני אלקובי , ד"ר רון ס.
הירשפרונג ו בנג'י עזריה – פיתחו מערכת מבוססת בינה מלאכותית, שנועדה להעריך בפני המשתמש את רמת הרגישות של הטקסט, ולהתריע כאשר התוכן פרטי או רגיש מדי, רגע לפני שהוא מעלה אותו לרשת. הפיתוח מציע כלים משמעותיים להתמודדות עם הסכנות ברשת, ויכול להיות קריטי במיוחד עבור הורים למתבגרים.
בני נוער נוטים לשתף תוכן אישי באופן ספונטני, ומערכת שכזו יכולה לתפקד כמעין תמרור אזהרה חכם שיעצור אותם רגע לפני השיתוף, ויעזור להם לקבל החלטות מודעות ובטוחות יותר. ד"ר אלקובי היא חברת סגל במחלקה להנדסת תעשייה וניהול באוניברסיטת אריאל.
היא עשתה דוקטורט במדעי המחשב ב אוניברסיטת בר אילן , ולאחר שנתיים של פוסט דוקטורט באוסטין, טקסס, חזרה לאריאל. ביום יום היא חוקרת מערכות מרובות סוכנים – אינטראקציה בין סוכנים ממוחשבים, בינם לבין אנשים, אסטרטגיות שונות, את תורת המשחקים ואיך אפשר להשתמש במידע כמשאב. הפרטיות היא חלק אינהרנטי מתחומי העיסוק שלה.
לדבריה, "אנחנו נותנים את המידע שלנו מבלי לחשוב, ויש מי שאוסף ושומר אותו. אנחנו צריכים לחשוב האם, כמשתמשים, נתינת הדאטה מניבה לנו יותר רווח או הפסד". ד"ר אלקובי נותנת שתי דוגמאות: "למשל, משתמש שמפרסם פוסט שהוא תומך במפלגה מסוימת בבחירות – מפלגה אחרת יכולה 'לראות' את המידע הזה, לפנות אליו ולהציע לו להצביע עבורה.
או, נניח, אני מפרסמת שאני בחו"ל – ומישהו רואה את המידע הזה ופורץ לבית שלי". הרשתות החברתיות והאפליקציות נהנות מהמצב הזה, ועונות לדרישות הרגולציה בכך שהן יוצאות ידי חובה. "הארגונים האלה מהירים יותר מהרגולציה. הם גם חכמים יותר ממנה – הם מפרסמים 'מגילה' שאף אחד לא קורא. זה המון טקסט בשפה מסורבלת ומשפטית.
אתה לא מבין את השפה הזאת ורוצה כל כך לקבל את המוצר – אז אתה לא קורא ולוחץ 'OK' באופן אוטומטי. זה נקרא עצלנות קוגניטיבית. בכך החברות מכסות את עצמן, אבל אנחנו, המשתמשים, בכל זאת נפגעים", אמרה ד"ר אלקובי. בתוך הסוגייה של הגנת הפרטיות יש תת סוגייה: לא כל אחד תופס את הפרטיות שלו, והגנתה, באותה הצורה.
אדם אחד ישתף ברשתות החברתיות, לדוגמה, שהוא לא מרגיש טוב, ואדם אחר לא, כי לתפיסתו, הוא יפגע בכך בפרטיות שלו. "ההנחה שהפרטיות והפגיעה בה הן אותו הדבר אצל כולם היא שגויה. הפגיעה בפרטיות צריכה להיבחן בצורה אישית", ציינה החוקרת. זוהי אחת מנקודות ההנחה שאיתן היא ועמיתיה יצאו למחקר שלהם.
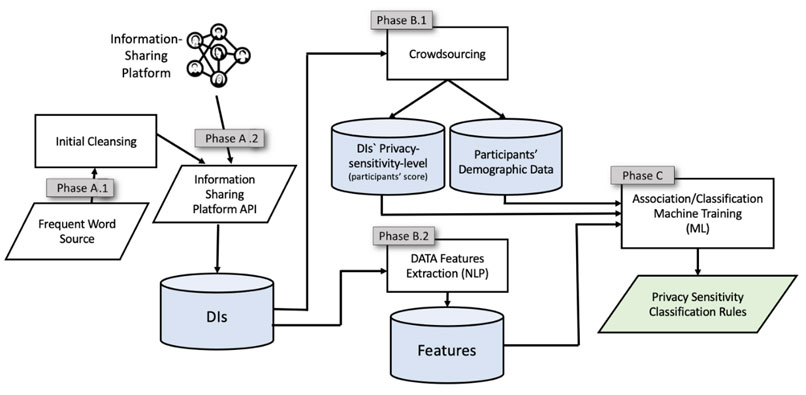
החוקרים ביצעו את המחקר באמצעות פלטפורמת מיקור ההמונים של אמזון . הם ביקשו מהמשתתפים לענות על שאלון שבנה את הפרופיל האישי של כל אחד מהם: הנתונים הדמוגרפיים שלהם – גיל, מגדר, השכלה, מוצא ועוד – ועסק באופן שבו הם תופסים פגיעה בפרטיות. בחלק השני של המחקר, מבצעיו השתמשו ב-API של X , שנותן גישה לציוצים רבים, אולם ללא שמות.
ד"ר אלקובי מתארת את השלבים של החלק הזה: "בשלב הראשון ביצענו איסוף וניקוי של הנתונים. דגמנו 1. 5 מיליון טוויטים רק כדי להבין את ההתפלגות של המילים בהם. מתוכם בחרנו 600 טוויטים, כדי שהמדגם יהיה כמה שיותר קרוב לאוכלוסייה שאנחנו רוצים לסקור.
הורדנו אזכורים, כפילויות ואימוג'ים, על מנת שיהיה רק טקסט קריא, ויצרנו שישה 'ציוצי בקרה' – שלושה שבטוח פוגעים בפרטיות ושלושה שבטוח לא". "לאחר מכן", ציינה, "כל משתמש קיבל 20 טוויטים רנדומליים פלוס השישה של הבקרה.
לכל ציוץ הוא נתן ציון בין 1 ל-5 עד כמה לדעתו הוא פוגע בפרטיות, כאשר 1 מסמל שהוא לא פוגע כלל ו-5 – שהוא פוגע מאוד. אספנו תשובות מ-1,489 משתתפים וסיננו את אלה שעלה חשד לגבי האמינות של תשובותיהם. נשארנו עם 471 משתתפים. כל המשתתפים היו בני 18+, אבל רק מיעוטם בני 60 ומעלה".
כדי להפוך כל ציוץ למשהו שכלי ה-AI שאיתו החוקרים עבדו יוכל להבין, הם השתמשו ב-NLP (עיבוד שפה טבעית), שהוא היכולת של המחשב להבין טקסט אנושי, ולימוד מכונה, ובתוך זה בלמידה מפוקחת – קבלת החלטות על פי דוגמאות ספציפיות.
"לקחנו את הנתונים, התייחסנו לכל נקודת דאטה כטקסט, שילבנו את זה עם הפרופיל האישי של המשתמש ולפי זה הגדרנו את הפגיעה בפרטיות", אמרה ד"ר אלקובי. "השתמשנו בטכנולוגיה של גוגל , שממירה את הטקסט לווקטורים, שמייצגים את המילים אבל גם את הכוונה של המשפט.
הבעיה היא שהכלי הזה ייצר עבורנו כל וקטור עם 768 ממדים (פרופילים מתומצתים, שמייצגים את המשתמש והטקסט – י"ה). לנתח משהו אונליין עם מספר ממדים כה גבוה זה לא ריאלי. השתמשנו בכלי להפחתת ממדים, ובסופו של דבר הגענו ל-92 ממדים. אז שילבנו את למידת המכונה, כאשר היא למדה בפועל 75% מהנתונים, וביתר השתמשנו לבקרה".
התוצאות, לדבריה, היו משביעות רצון: הפער הממוצע בין התיוגים של המשיבים לממצאים של המכונה היה 0. 18 בלבד, כאשר ב-96. 6% מהמקרים, הוא היה פחות מ-0. 4. ד"ר רון ס. הירשפרונג (מימין) ובנג'י עזריה מאוניברסיטת אריאל. צילום: פרטי (עיבוד ממוחשב: ג'מיני) השוויתם את המחקר שלכם מול מחקרים אחרים שנעשו בתחום? "בהחלט.
השווינו את התוצאות שלנו עם מחקרים מרחבי העולם, שבוצעו על כלים אחרים של AI. הכלי שלנו ניצח". כל מחקר צריך להציג חידוש לעומת המחקרים האחרים. מה החידוש במחקר שהצגתם? "החידוש הוא שהמערכת שפיתחנו היא מקצה לקצה.
היא לוקחת טכנולוגיית שפה מתקדמת עם מיקור ההמונים ובודקת פגיעה בפרטיות מנקודת מבט סובייקטיבית, ועושה את זה בצורה אוטומטית בזמן אמת". מה עם אבטחת המערכת? המשתמשים מכניסים לשם נתונים אישיים, וגם כאן עלולה להיות פגיעה בפרטיות. "אמת, אבל עדיין לא הגענו לזה, ולא חשבנו על זה עד הסוף.
אין ספק שנחשוב על זה עד הסוף אם וכאשר נמסחר את המערכת". אם וכאשר המערכת שלכם תגיע לפרודקשן ותצא לשוק – במה היא יכולה להועיל לי, כמשתמש? "המערכת תיתן לך התראות על פגיעה אפשרית בפרטיות בטקסט, תמונה או סרטון שאתה מתכוון להעלות, ועוד.
היא תעשה זאת על בסיס תרגום מטקסט חופשי למידע שהמחשב יכול להבין, סוכן חכם שיודע להעריך את הפגיעה בפרטיות הספציפית על פי ההגדרות שלך, שימוש בממשק שיעזור לך לקבל את רמת הפרטיות שאתה רוצה.
אנחנו מסתובבים סביב הפרט, במטרה לבנות את כל היכולות שייצרו עבורו מערכת אוטומטית, ממוחשבת וידידותית, שתסייע לו לשמור על עצמו במרחב הדיגיטלי".